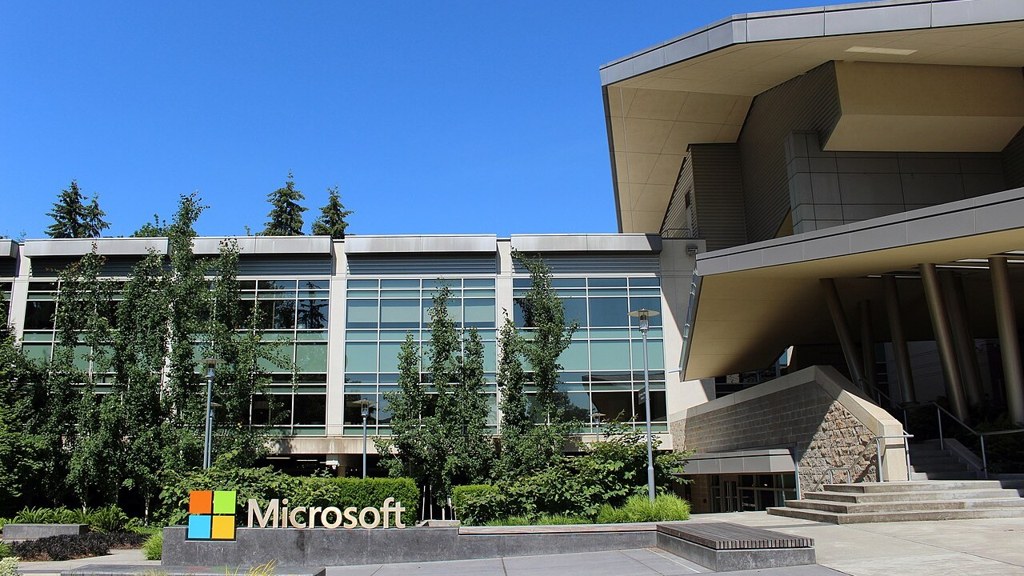
La caída de Microsoft 365 que el jueves y el viernes de la semana pasada dejó sin respuesta a servicios usados por millones de personas en todo el mundo tuvo una explicación oficial este lunes 16 de noviembre: un defecto latente introducido en una actualización de julio, una carga mayor de la habitual y una capacidad de servidores reducida se combinaron hasta provocar un fallo en cascada que, en su peor momento, afectó a más del 80 % de los servidores de la plataforma.
La explicación la ofreció Charles Lamanna, vicepresidente ejecutivo de Copilot, Agentes y Plataforma en Microsoft, en un largo mensaje publicado en X. Según su relato, ninguno de los tres factores por separado bastaba para tumbar el servicio: fue la coincidencia de todos en la misma ventana de horas lo que activó un problema que llevaba más de tres meses dormido dentro del sistema, sin causar síntomas visibles.
Caída de Microsoft 365: el defecto que dormía desde julio
El primer factor fue el propio defecto. Lamanna explicó que una contención de bloqueos dentro de un proceso interno hacía que los servidores se sobrecargaran y dejaran de responder bajo ciertas condiciones de carga, hasta que la máquina quedaba no disponible. El fallo entró en una actualización que comenzó a desplegarse en julio y permaneció latente durante más de tres meses.
El detalle que más llama la atención es por qué las pruebas no lo detectaron. Según el ejecutivo, el problema de contención no se manifestó en los laboratorios de la compañía, pero sí en equipos con más núcleos y hardware más reciente, más potentes que las configuraciones con las que se hacían las pruebas. Es decir: el entorno de ensayo era menos exigente que el entorno real, y el defecto solo apareció donde el sistema trabajaba con su configuración más avanzada.
Teams cambió de puerta de enlace y subió la carga
El segundo factor fue el aumento de la carga. Microsoft 365 cuenta con dos sistemas de puerta de enlace de red independientes que permiten pasar el tráfico de uno a otro cuando hay problemas. Unas quince horas antes de la caída global, Teams, la plataforma de comunicación y colaboración, cambió de puerta de enlace y entró en la que da servicio al correo electrónico Exchange Online.
Ese movimiento modificó los patrones de tráfico y elevó la probabilidad de que las puertas de enlace experimentaran justamente el problema de contención que el defecto de julio había dejado sembrado. A eso se sumó el tercer factor: al mismo tiempo, casi el 14 % de la capacidad de servidores de la puerta de enlace estaba fuera de servicio por un problema no relacionado, ocurrido el día anterior. Con menos capacidad disponible y más carga circulando, el fallo latente se activó.
Lo que se sabe hasta ahora:Origen: un defecto introducido en una actualización desplegada desde julio. Detonantes: el cambio de puerta de enlace de Teams, unas 15 horas antes, y un 14 % de capacidad fuera de servicio. Alcance: más del 80 % de los servidores afectados en el peor momento. Respuesta oficial: Charles Lamanna, vicepresidente ejecutivo de Microsoft, en un mensaje en X este lunes 16 de noviembre.
Una recuperación lenta: el tráfico en espera volvía a tumbar los servidores
Cuando los primeros servidores dejaron de responder, la redistribución automática del tráfico hacia otros equipos provocó el fallo en cascada: cada máquina que recibía la carga extra quedaba expuesta a la misma contención. Y la recuperación tomó más tiempo de lo habitual por una razón que Lamanna describió con franqueza: a medida que los servidores regresaban al servicio, se veían abrumados de inmediato por el tráfico en espera y volvían a dejar de responder.
Para los usuarios, la caída se tradujo en horas sin acceso normal a herramientas de trabajo diario como el correo de Exchange Online y las comunicaciones de Teams, en empresas y administraciones de todo el mundo que dependen de Microsoft 365. La jornada tecnológica convive además con otros frentes de tensión global que esta redacción sigue de cerca, como la alerta de los reguladores de 38 países sobre el riesgo nuclear en Ucrania y el debate presidencial en Francia que marcó la agenda europea del lunes.
Microsoft promete más detalles esta semana
Lamanna agregó que la empresa ofrecerá más detalles sobre el incidente a lo largo de esta semana. Esa ampliación será la prueba real de la explicación: deberá precisar cuántos usuarios y servicios se vieron afectados, durante cuánto tiempo y qué cambios se aplicarán para que un defecto introducido en una actualización no vuelva a permanecer tres meses sin ser detectado por los propios laboratorios de la compañía.
El caso deja una lección que va más allá de Microsoft: cuando una sola plataforma concentra el correo, las reuniones y los documentos de millones de trabajadores, un fallo interno se convierte en un problema global en cuestión de horas. Por eso la caída de Microsoft 365 no fue solo un incidente técnico, sino un recordatorio de la dependencia diaria que oficinas enteras, también en América Latina y en Estados Unidos, tienen de estos servicios.